2017年9月28日木曜日

PyTorch練習 03日目

MorvanZhou/PyTorch-Tutorialを参考にMNISTの数字判別MLPを組んだ (元ネタはCNN).


import torch 
import torchvision
import torch.nn as nn
import numpy as np
import torch.utils.data as data
import torchvision.transforms as transforms
import torchvision.datasets as dsets
from torch.autograd import Variable
import matplotlib.pyplot as plt
import torch.nn.functional as F

EPOCH = 3
BATCH_SIZE = 50
LR = 0.001


transforms = torchvision.transforms.Compose([
                torchvision.transforms.ToTensor()
                ])
train_data = torchvision.datasets.MNIST(
    root='./', train=True, download=True, transform=transforms)


train_loader = torch.utils.data.DataLoader(
    dataset=train_data, batch_size=BATCH_SIZE, shuffle=True)

test_data = torchvision.datasets.MNIST(root='./', train=False)
test_x = Variable(torch.unsqueeze(test_data.test_data, dim=1)
                 .view(-1, 28*28), volatile=True).type(torch.FloatTensor)[:2000]/255
test_y = test_data.test_labels[:2000]

mlp = torch.nn.Sequential(
            torch.nn.Linear(28*28, 100),
            torch.nn.ReLU(),
            torch.nn.Linear(100, 30),
            torch.nn.ReLU(),
            torch.nn.Linear(30, 10)
)

print(mlp)

optimizer = torch.optim.Adam(mlp.parameters(), lr=LR)
loss_fn = nn.CrossEntropyLoss()

for epoch in range(EPOCH):
    for step, (x, y) in enumerate(train_loader):
        b_x = Variable(x.view(50, 28*28))
        b_y = Variable(y)

        output = mlp(b_x)

        loss = loss_fn(output, b_y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        if step % 100 == 0:
            test_output = mlp(test_x)
            pred_y = torch.max(test_output, 1)[1].data.squeeze()
            accuracy = sum(pred_y == test_y) / float(test_y.size(0))
            print('Epoch: ', epoch, '| train loss: %.4f' % loss.data[0],
                 '| test accuracy: %.2f' % accuracy)
MLP (
  (layer1): Sequential (
    (0): Linear (784 -> 100)
    (1): ReLU ()
    (2): Linear (100 -> 30)
    (3): ReLU ()
    (4): Linear (30 -> 10)
  )
)
Epoch:  0 | train loss: 2.3134 | test accuracy: 0.09
Epoch:  0 | train loss: 0.7347 | test accuracy: 0.81
Epoch:  0 | train loss: 0.4593 | test accuracy: 0.85
Epoch:  0 | train loss: 0.4268 | test accuracy: 0.88
Epoch:  0 | train loss: 0.1728 | test accuracy: 0.89
Epoch:  0 | train loss: 0.2370 | test accuracy: 0.89
Epoch:  0 | train loss: 0.0994 | test accuracy: 0.90
Epoch:  0 | train loss: 0.2626 | test accuracy: 0.90
Epoch:  0 | train loss: 0.1483 | test accuracy: 0.91
Epoch:  0 | train loss: 0.2041 | test accuracy: 0.92
Epoch:  0 | train loss: 0.1486 | test accuracy: 0.91
Epoch:  0 | train loss: 0.2538 | test accuracy: 0.92
Epoch:  1 | train loss: 0.0768 | test accuracy: 0.93
Epoch:  1 | train loss: 0.1138 | test accuracy: 0.93
Epoch:  1 | train loss: 0.1675 | test accuracy: 0.93
Epoch:  1 | train loss: 0.0724 | test accuracy: 0.93
Epoch:  1 | train loss: 0.0983 | test accuracy: 0.94
Epoch:  1 | train loss: 0.1681 | test accuracy: 0.93
Epoch:  1 | train loss: 0.1569 | test accuracy: 0.94
Epoch:  1 | train loss: 0.2666 | test accuracy: 0.94
Epoch:  1 | train loss: 0.1030 | test accuracy: 0.93
Epoch:  1 | train loss: 0.1784 | test accuracy: 0.93
Epoch:  1 | train loss: 0.2013 | test accuracy: 0.95
Epoch:  1 | train loss: 0.1681 | test accuracy: 0.95
Epoch:  2 | train loss: 0.0487 | test accuracy: 0.95
Epoch:  2 | train loss: 0.0959 | test accuracy: 0.95
Epoch:  2 | train loss: 0.1366 | test accuracy: 0.95
Epoch:  2 | train loss: 0.1528 | test accuracy: 0.95
Epoch:  2 | train loss: 0.0860 | test accuracy: 0.95
Epoch:  2 | train loss: 0.0218 | test accuracy: 0.95
Epoch:  2 | train loss: 0.1122 | test accuracy: 0.95
Epoch:  2 | train loss: 0.1109 | test accuracy: 0.96
Epoch:  2 | train loss: 0.0879 | test accuracy: 0.96
Epoch:  2 | train loss: 0.1182 | test accuracy: 0.96
Epoch:  2 | train loss: 0.0585 | test accuracy: 0.96
Epoch:  2 | train loss: 0.0579 | test accuracy: 0.95

DataLoaderの使い方がまだわかっていないので引き続き練習する.
また,numpy.Array.reshapeと似た機能をもつまた,Torch.Tensor.viewについていくつかメモしておく.
この変換はtorchvision.datasets.MNISTのtransformの段階で行ったほうが効率がいいと思うが,どうやればいいのかわからなかった.

A = torch.arange(0, 5* 4 * 3 * 2) # 長さ120の一次元Tensor
A.view(5, 4, 3, 2)      # size (5, 4, 3, 2) の4次元Tensor
A.view(5, -1)           # size (5, 24) の二次元Tensor
                        # -1を引数にすると,他の次元を勘案してその次元のsizeが決まる.
A.view(7, -1)           
# RuntimeError: invalid argument 2: size '[7 x -1]' is invalid for input of with 120 elements at /pytorch/torch/lib/TH/THStorage.c:37

2017年9月27日水曜日

PyTorch練習 02日目 2

単純な線形回帰をPyTorchで実装する.

import numpy as np
import torch
from torch.autograd import Variable
import torch.nn.functional as F
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

torch.manual_seed(1)
class LinearRegression(object):
    """
    二乗誤差をloss functionとした線形回帰

    methods:
        fit(X, y, lr, n_iter) fit linear model
            X: data matrix(numpy.array)
            y: data matrix(numpy.array)
            lr: learning rate, defalt 1e-3
            n_iter: number of iteration, default 5000
        get_params() get parameters for this estimator
            return: 
        predict(X) predict using the linear model
            X: data matrix(numpy.array) 
    """

    def __init__(self):
        pass

    def fit(self, X, y, lr=1e-3, n_iter=5000):
        X = Variable(torch.from_numpy(X).float())      # 何かエラーが起きたら手当り次第
        y = Variable(torch.from_numpy(y).float())      # flaot()にすると解決するかも
        self.model = torch.nn.Sequential(              # 線形レイヤー1枚を線形回帰の
            torch.nn.Linear(X.size()[1], y.size()[1])) # パラメータ学習器にする
        loss_fn = torch.nn.MSELoss(size_average=False)
        optimizer = torch.optim.Adam(self.model.parameters(), lr=lr)

        for t in range(n_iter):
            y_pred = self.model(X)
            loss = loss_fn(y_pred, y)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

    def get_params(self):
        try:
            return list(model.parameters())
        except ValueError:
            print("We need to fit any data first")

    def predict(self,X):
        X = Variable(torch.from_numpy(X).float())
        try:
            return self.model(X)
        except ValueError:
            print("We need to fit any data first")
x1 = np.linspace(-1, 1, 100)
x2 = np.linspace(-1, 1, 100)
X = np.vstack((x1, x2)).T
y = 2 * x1 + 1 * x2 + 0.5 * np.random.randn(100) + 1
y = y.reshape([100, 1])

lr = LinearRegression()
lr.fit(X, y)

fig = plt.figure(figsize=(9, 9))
ax = fig.add_subplot(111, projection='3d')


ax.scatter(x1, x2, y, label='data')
ax.scatter(x1, x2, lr.predict(X).data.numpy(), label='prediction')
plt.legend()
plt.show()

enter image description here

X = np.linspace(-1, 1, 100).reshape([100, 1])
y = 2 * X + 0.5 * np.random.randn(100, 1)
lr = LinearRegression()
lr.fit(X, y)
plt.scatter(X, y, label='data')
plt.scatter(X, lr.predict(X).data.numpy(), label='predict')
plt.legend()
plt.show()

enter image description here

PyTorch練習 02日目

MIT License
元ネタ: jcjohnson/pytorch-examples

PyTorch: Tensors

# Program 1 素朴なMLPの実装
import torch
dtype = torch.FloatTensor          # CPU上の32-bit floating point
# dtype = torch.cuda.FloatTensor   # GPU上の32-bit floating point

# D_in x H x D_outの三層ニューラルネットを構成する.
N, D_in, H, D_out = 64, 1000, 100, 10

# データセットの作成
x = torch.randn(N, D_in).type(dtype)
y = torch.randn(N, D_out).type(dtype)

# 重み行列の作成
w1 = torch.randn(D_in, H).type(dtype)
w2 = torch.randn(H, D_out).type(dtype)

# Gradient Descentによる最適化
learning_rate = 1e-6
for t in range(500):                 
    h = x.mm(w1)                     # matrix multiplication
    h_relu = h.clamp(min=0)          # Clamp all elements in input into the range [min, max] and return a resulting Tensor.
    y_pred = h_relu.mm(w2)

    # compute and print loss
    loss = (y_pred - y).pow(2).sum()
    if t % 50 == 0:
        print(t, loss)

    # backpropagation
    grad_y_pred = 2.0 * (y_pred - y)
    grad_w2 = h_relu.t().mm(grad_y_pred) # a.t() : transpose
    grad_h_relu = grad_y_pred.mm(w2.t())
    grad_h = grad_h_relu.clone()
    grad_h[h<0] = 0
    grad_w1 = x.t().mm(grad_h)

    # gradient descent
    w1 -= learning_rate * grad_w1
    w2 -= learning_rate * grad_w2
0 33983926.96143705
50 11801.846684516087
100 357.2751016973617
150 17.174204719908438
200 1.006447628455322
250 0.06717062689924691
300 0.005198379904488515
350 0.0006403423317780793
400 0.0001579846401805196
450 6.24626183654553e-05

PyTorch: Variables and autograd

Program 1では手動でbackpropagationを行って勾配を計算したが,PyTorchでは変数をVariable型でラップすることで,その変数に対する写像の勾配を簡単に計算できる.

# Program 2 自動微分を使った三層MLPの実装
import torch
from torch.autograd import Variable
dtype = torch.FloatTensor          # CPU上の32-bit floating point
# dtype = torch.cuda.FloatTensor   # GPU上の32-bit floating point

# D_in x H x D_outの三層ニューラルネットを構成する.
N, D_in, H, D_out = 64, 1000, 100, 10

# データセットの作成
# データセットについての勾配は不要なので,requires_grad=Falseとする.
x = Variable(torch.randn(N, D_in).type(dtype), requires_grad=False)
y = Variable(torch.randn(N, D_out).type(dtype), requires_grad=False)

# 重み行列の作成
# 重み行列でloss functionを最適化するため,重み行列による勾配が必要. requires_grad=True
w1 = Variable(torch.randn(D_in, H).type(dtype), requires_grad=True)
w2 = Variable(torch.randn(H, D_out).type(dtype), requires_grad=True)

# GDによる最適化
learning_rate = 1e-6
for t in range(500):
    # backpropagationを手動ではしないので,中間の計算結果は保存しない.
    y_pred = x.mm(w1).clamp(min=0).mm(w2)

    loss = (y_pred - y).pow(2).sum()  # lossはVariableに対する演算の結果なのでVariable
                                      # VariableはTensorであり,実数は(1,)のTensorとして格納され,
                                      # v.data[0]によってただの実数として取り出せる.
    if t % 50 == 0:
        print(loss.data[0])

    # backward passの前に手動で勾配を0にする (前のループでの勾配を初期化するということ?)
    # もとの例ではt=0の場合にも初期化を行っていたが,最新のPyTorchだとエラーになる.
    if t: 
        w1.grad.data.zero_()
        w2.grad.data.zero_()

    # loss.backward()によって,lossに至るまでの全ての変数に対する勾配を計算する.
    # w1.grad, w2.gradで計算した勾配を読める.
    loss.backward()

    w1.data -= learning_rate * w1.grad.data
    w2.data -= learning_rate * w2.grad.data
33022228.0
13424.4697265625
475.697021484375
26.867782592773438
1.9564745426177979
0.1696002036333084
0.016552181914448738
0.0019943274091929197
0.0004035909951198846
0.00013585695705842227

PyTorch: nn

autogradよりも抽象的で,大規模なnetworkの記述に向いたツールにnn パッケージが有る. neural networkはいくつものlayerが重なって構成されており,層ごとにlearnable parametersをもつことがある. nnにはModuleの集合が定義されていて,それぞれがlayerの抽象化と考えることが出来る. ModuleはVariableのインスタンス(たち)を与えられてVariableのインスタンス(たち)を返し,かつlearnable parametersを含む内部状態をVariableのインスタンスとして持つ. また,nnは有用なloss functionを予め定義している. Program 3はnnによる3層のneural networkの例である.

# Program 3
import torch
from torch.autograd import Variable

N, D_in, H, D_out = 64, 1000, 100, 10

x = Variable(torch.randn(N, D_in))
y = Variable(torch.randn(N, D_out), requires_grad=False)


# torch.nn.Sequential() の引数にlayerたちを記述し,その順番にlayerを繋げたnetworkがモデルとなる.
# layerたちのもつパラメータmodelに保存されていて,あとで勾配を計算できる.
# 引数にmoduleを入れてネストした構造を作ることも出来る. 
# moduleを組み合わせてmodelすなわちnetworkを構成する.
model = torch.nn.Sequential(
        torch.nn.Linear(D_in, H),
        torch.nn.ReLU(),
        torch.nn.Linear(H, D_out),
)

# torch.nnは代表的なloss functionを予め定義している. ここではMSEを使う.
loss_fn = torch.nn.MSELoss(size_average=False)

learning_rate = 1e-4
for t in range(500):
    # Forward pass
    # modelは関数であるかのように呼べて,ここではxを引数とする.
    y_pred = model(x)

    # lossを計算する. y_predにmodelの情報(networkの全てのパラメータ)が保存されているから
    # あとでloss.backward()をするだけでnetworkのパラメータによるlossの勾配が計算される.
    # loss_fn()の返り値はまたVariableのインスタンス.
    loss = loss_fn(y_pred, y)
    if t % 50 == 0:
        print(t, loss.data[0])

    # gradientの初期化
    if t:
        model.zero_grad()

    loss.backward() # これによってgradientが計算される.

    # gradient descentの更新.
    # model.parameters()がモデルの全てのパラメータである.
    # modelのパラメータはVariableだから,以下のように更新する. 
    for param in model.parameters():
        param.data -= learning_rate * param.grad.data
0 697.54541015625
50 30.74203872680664
100 2.117093086242676
150 0.22655823826789856
200 0.03121182695031166
250 0.005095028784126043
300 0.0009658429189585149
350 0.0002087247121380642
400 4.9990881962003186e-05
450 1.284706377191469e-05

PyTorch:optim

これまではGradient Descentによって最適化を行ってきたが,より洗練された最適化手法は多くあるが,いちいち実装していては大変なので,optim packageは有用な最適化手法を定義している. Program 4はAdam methodによる最適化をoptimによって実現している.

# Program 4
import torch
from torch.autograd import Variable

N, D_in, H, D_out = 64, 1000, 100, 10
x = Variable(torch.randn(N, D_in))
y = Variable(torch.randn(N, D_out))

model = torch.nn.Sequential(
    torch.nn.Linear(D_in, H),
    torch.nn.ReLU(),
    torch.nn.Linear(H, D_out),
)

loss_fn = torch.nn.MSELoss(size_average=False)

# optimによってOptimizerを定義する. ここではAdamを使うが,ほかにも多くの手法が定義されている.
# torch.optim.Adamの最初に与える引数が,最適化を行う変数の集合である.
learning_rate = 1e-4
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
for t in range(500):
    y_pred = model(x)

    loss = loss_fn(y_pred, y)
    if t % 50 == 0:
        print(t, loss.data[0])

    optimizer.zero_grad() # これはわざわざtが0出ないことを確かめなくてもエラーを起こさない

    loss.backward()

    # optimizerのstep()メソッドによって,最適化するパラメータを1回更新する.
    optimizer.step()
0 668.1607055664062
50 200.53623962402344
100 51.36286163330078
150 8.457684516906738
200 0.8371148705482483
250 0.06822004914283752
300 0.005305096507072449
350 0.0003715920902322978
400 2.1446359824039973e-05
450 9.826173936744453e-07

PyTorch: Custom nn Modules

nn.Moduleのサブクラスとして新たなmoduleを定義できる.
それには,与えられた入力(Variableのインスタンス)をautogradの演算で望む出力(Variableのインスタンス)に変換する写像をforwardとして実装する. Program 5は3層のネットワークを一つのmoduleとして定義して作ったnetworkの実装例である.

# Program 5
import torch
from torch.autograd import Variable

class TwoLayerNet(torch.nn.Module):
    def __init__(self, D_in, H, D_out):
        """
        constuctorにおいて2つのnn.Linearをインスタンス化して,Variableの一員とする
        """
        super(TwoLayerNet, self).__init__()
        self.linear1 = torch.nn.Linear(D_in, H)
        self.linear2 = torch.nn.Linear(H, D_out)

    def forward(self, x):
        h_relu = self.linear1(x).clamp(min=0)
        y_pred = self.linear2(h_relu)
        return y_pred

N, D_in, H, D_out = 64, 1000, 100, 10

x = Variable(torch.randn(N, D_in))
y = Variable(torch.randn(N, D_out), requires_grad=False)

model = TwoLayerNet(D_in, H, D_out)

# loss functionとopimizerを定義する. 
criterion = torch.nn.MSELoss(size_average=False)
optimizer = torch.optim.SGD(model.parameters(), lr=1e-4)
for t in range(500):
    y_pred = model(x)

    loss = criterion(y_pred, y)
    if t % 50 == 0:
        print(t, loss.data[0])

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
0 719.2647705078125
50 33.10668182373047
100 2.121030569076538
150 0.22128432989120483
200 0.030644414946436882
250 0.005116437561810017
300 0.00095479900483042
350 0.00019043088832404464
400 3.9648610254516825e-05
450 8.519250513927545e-06

2017年9月26日火曜日

PyTorch練習 01日目

PyTorchは人気上昇中のニューラルネットワークライブラリ. numpyと親和性が高い.

from __future__ import print_function
import numpy as np
import torch
from torch.autograd import Variable

PyTorchの変数はtorch.Tensor型として定義し,numpy.arrayと似た振る舞いをする.

x = torch.Tensor(5, 3) # メモリは初期化されない
print(x)
 0.0000e+00  0.0000e+00  5.7260e+31
 4.5801e-41  2.6699e+09  4.5801e-41
-1.3889e-14  3.0737e-41 -1.3889e-14
 3.0737e-41  3.3887e+37  4.5801e-41
 3.2915e+37  4.5801e-41  1.7148e+29
[torch.FloatTensor of size 5x3]
torch.rand(5, 3) #[0, 1]上の一様分布
 0.0090  0.0027  0.8066
 0.7704  0.8939  0.8752
 0.2019  0.2329  0.0885
 0.9281  0.5321  0.4206
 0.4536  0.0725  0.3961
[torch.FloatTensor of size 5x3]
torch.randn(5, 3) # 標準正規分布
 0.9565 -0.0533 -0.1352
 0.7636  0.0229  1.2910
 0.2379 -0.4774 -1.2879
 0.3506 -0.2690  0.9901
 0.1157 -0.3185 -0.0382
[torch.FloatTensor of size 5x3]
torch.ones(5, 3)
 1  1  1
 1  1  1
 1  1  1
 1  1  1
 1  1  1
[torch.FloatTensor of size 5x3]
torch.zeros(5, 3)
 0  0  0
 0  0  0
 0  0  0
 0  0  0
 0  0  0
[torch.FloatTensor of size 5x3]
torch.diag(torch.arange(0, 5))
 0  0  0  0  0
 0  1  0  0  0
 0  0  2  0  0
 0  0  0  3  0
 0  0  0  0  4
[torch.FloatTensor of size 5x5]
torch.eye(5)
 1  0  0  0  0
 0  1  0  0  0
 0  0  1  0  0
 0  0  0  1  0
 0  0  0  0  1
[torch.FloatTensor of size 5x5]
print(x[:, 1])  # インデクシングもpythonと変わらない
 0.0000e+00
 2.6699e+09
 3.0737e-41
 3.3887e+37
 4.5801e-41
[torch.FloatTensor of size 5]
a = np.ones(5)           # numpy.arrayからtorch.Tensorへの変換
b = torch.from_numpy(a)  # このときaに加えた変更はbに遺伝する
np.add(a, 1, out=a)      # 忘れていると痛い目にあいそう
print(a)
print(b)
[ 2.  2.  2.  2.  2.]

 2
 2
 2
 2
 2
[torch.DoubleTensor of size 5]
torch.cuda.is_available() # cudaが使えるか判定
True
x = x.cuda() # .cuda()によってGPUメモリ上に変数を移動できる.
x
 0.0000e+00  0.0000e+00  5.7260e+31
 4.5801e-41  2.6699e+09  4.5801e-41
-1.3889e-14  3.0737e-41 -1.3889e-14
 3.0737e-41  3.3887e+37  4.5801e-41
 3.2915e+37  4.5801e-41  1.7148e+29
[torch.cuda.FloatTensor of size 5x3 (GPU 0)]

自動微分

PyTorchでは勾配計算をするときは変数をtorch.autograd.Variable型に入れる.
Variableのインスタンスはrequires_gradvolatileの二つのフラグを持っていて,これらのフラグをもとに勾配計算に置いて考慮しないくていいsubgraphを除外し,効率的な計算を実現している.

requires_grad

変数が関数の引数となるとき,もまたによって勾配計算が出来るべきで,逆に言えば,の勾配を計算できなくてもよいのはの全てが勾配を計算しなくても良いときである.

x = Variable(torch.ones(2, 2), requires_grad=True)
y = 2 * x
z = y * y * 3
print(y.requires_grad, z.requires_grad)
True True
x = Variable(torch.ones(2, 2), requires_grad=False)
y = 2 * x
z = sum(sum(y))
print(y.requires_grad, z.requires_grad)
False False

と関数があって,と書けるとする.
がrequires_gradであるときもrequires_gradであって,.backward()としてから.gradとすると,が得られる. また,で,.backward()としてから.gradとするとが得られる.

x = Variable(torch.ones(2, 2), requires_grad=True)
y = 2 * x
z = y * y * 3
out = z.mean()
out.backward()
print(y.backward)
<bound method Variable.backward of Variable containing:
 2  2
 2  2
[torch.FloatTensor of size 2x2]
>
print(x.backward)
<bound method Variable.backward of Variable containing:
 1  1
 1  1
[torch.FloatTensor of size 2x2]
>
x = Variable(torch.ones(2, 2), requires_grad=True)
y = 2 * x
z = y * y * 3
out = z.mean()
z.backward()      # zが多次元なためにエラー
x.grad            
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-20-c3877ab6bd13> in <module>()
      3 z = y * y * 3
      4 out = z.mean()
----> 5 z.backward()      # zが多次元なためにエラー
      6 x.grad


/usr/local/lib/python3.5/dist-packages/torch/autograd/variable.py in backward(self, gradient, retain_graph, create_graph, retain_variables)
    154                 Variable.
    155         """
--> 156         torch.autograd.backward(self, gradient, retain_graph, create_graph, retain_variables)
    157 
    158     def register_hook(self, hook):


/usr/local/lib/python3.5/dist-packages/torch/autograd/__init__.py in backward(variables, grad_variables, retain_graph, create_graph, retain_variables)
     84         grad_variables = list(grad_variables)
     85 
---> 86     grad_variables, create_graph = _make_grads(variables, grad_variables, create_graph)
     87 
     88     if retain_variables is not None:


/usr/local/lib/python3.5/dist-packages/torch/autograd/__init__.py in _make_grads(outputs, grads, user_create_graph)
     32             if out.requires_grad:
     33                 if out.numel() != 1:
---> 34                     raise RuntimeError("grad can be implicitly created only for scalar outputs")
     35                 data = out.data
     36                 new_grads.append(


RuntimeError: grad can be implicitly created only for scalar outputs

2017年9月16日土曜日

MIT OCW, Machine Learning 16日目

Rohit Singh, Tommi Jaakkola, and Ali Mohammad. 6.867 Machine Learning. Fall 2006. Massachusetts Institute of Technology: MIT OpenCourseWare, https://ocw.mit.edu. License: Creative Commons BY-NC-SA.

Bayesian networks

Bayesian networkは確率的な情報を表現し,使うのに有用なモデルである. Bayesian networkは1. 有向グラフと,2. それに付随する確率分布からなる. グラフは確率変数たちの質的な関係(条件付き独立性)を表現し,確率分布は確率変数たちの量的な関係を記述する. HMMでforward-backward algorithmが効率的であったのはMarkov性ゆえであり,これをBayesian networkの場合にも一般化するため,確率変数同士の独立性,条件付き独立性,従属性を明確に記述するグラフは非常に重要である.
まずは単純なBayesian networkを挙げる(fig.1). 確率変数は独立なコイントスの結果で,のどちらかの値を取る. またで確率変数を定義する. 状況設定から同時分布は

とわかるが,同じ分布をfig.1のグラフだけから導ける. その前にいくつかの用語を定義する.
からへの辺が有るから,parent(親)であり,child(子)であるという. もまたの親であり,このときに従属する. グラフに合致した同時確率分布は必ず,それぞれの確率変数の親たちによって条件付けられた条件付き確立の積として書ける. よって(1)はfig.1のグラフと合致している.

Marginal independence and induced dependence


このように,他の確率変数を無視すると周辺分布が独立になるとき,marginary independentであるという. これはグラフからも見て取れる.

確率変数のもう一つの典型的な関係はinduced dependenceである. の現れを与えられず,の現れのみを与えられた場合を考える.ならばのどちらかに決まり,ならばに決まるから,が決まればが決まるし,が決まればが決まる. すなわちが決定されるとdependentな関係になる. これは後で述べる方法によってグラフから見て取れる.

marginal independence とinduced dependenceは現実のモデルでよく現れる. fig.2cのfactorial Hidden Markov Modelはその例である. このモデルでは2つの周辺独立なMarkov chainが観測値を作り出している. 換言すれば,2つのMarkov chainが観測値によってのみ結び付けられているということである(induced dependence). このモデルからサンプリングするには,2つのMarkov modelから独立にサンプリングを行い,各時点において2つのstateから観測値をサンプリングする. fig.2cの同時分布は

とfactorizationできる. このモデルは例えば二人が話しているのを1つのマイクで録音し,それぞれの人が何を話したか推測したり,2つのハプロタイプから生成された表現型からもとのハプロタイプを推測するのに利用できる.

Explaining away

また,Bayesian networkでうまく把握できる確立モデルにexplaning awayがある.Pearl, 1988による,強盗警報機の鳴る原因のモデル(fig.3)を例に見る. 4つの二値(0, 1)確率変数があって,
は警報機,,は地震,はラジオで地震情報がなされていることを代表している.

を仮定する. fig.3で影のついた確率変数の情報のみを持っているとする.
のみが解っているときを考える(fig.3.b).の少なくとも一方が成立しているとわかるが,ともに滅多に生じない事象だから,は必ず起きないと仮定する. この仮定のもとでの情報を得たらを確信し,を排除(explain away)できる. したがって

である. ここでのもとで条件付き従属であることを使った.これもまたグラフから見て取れる性質である.

Bayesian networks and conditional independence

グラフはもともと変数の独立性をencodeしているから,その独立性をextractするための基準が必要である. Bayesian networkの場合,この基準をD-separtation criterionという.

例えば先程のモデルを拡張したfig.4aを考える.ここでは,警報がなったので帰宅したという事象を代表する変数である. のもとで独立か否かと言った問いに答えるための手順を考える.
1. 対象の変数のancestral graphを構成する. ここでは対象とはであって,ancestral graphはこれらとともに,これらの変数に至る有向辺を何ステップでも辿って現れる変数全てを含む. 今の場合,ancestral graphはfig.4bである.
2. 得られたancestral graphにおいて,子ノードを共有するノード間に無向辺を加える. 3つ以上のノードが子ノードを共有する場合には,それらのつくる全てのペアについて辺を加える(fig.4c).これをmoralizeという.
3. 全ての有向辺を無向辺に置き換え,無向グラフ(fig.4d)を得る.

結果得られた無向グラフから,もとの問の答えを読み取れる. 得られた無向グラフからとそれに結ばれた辺を取り去ったとき,を結ぶpathが存在しなければによって条件付き独立であり,存在すれば条件付き独立であると言える. したがってfig.4dから,によって条件付き従属である.

fig.1に立ち返り,D-separated criterionを使うと,fig.5によってがmarginally independentであることが見て取れるし,fig.6からによって条件付従属であることが見て取れる.

Graph and the probability distribution

以上の議論は,グラフとそれに対応付けられる確率分布がconsistentであるときにのみ成立する. consistentとは,グラフから見て取れる全ての(条件付き含む)独立性が,確率分布の上でも言えるということである. グラフから見て取れる独立性というのは数多く存在する.
個のノードをもつ循環しないグラフが与えられたとき,

はそのグラフとconsistentであることが知られている.ただしの親ノードの集合である.

2017年9月14日木曜日

MIT OCW, Machine Learning 15日目

Rohit Singh, Tommi Jaakkola, and Ali Mohammad. 6.867 Machine Learning. Fall 2006. Massachusetts Institute of Technology: MIT OpenCourseWare, https://ocw.mit.edu. License: Creative Commons BY-NC-SA.
Lecture 19, 20.

は初期分布,はstateの数とする.またMarkov chainの初期のstateはである.

Markov chains(cont’d)

Markov chainを記述する方法には2つある. state transition diagramgraphical modelである. transition diagramはstateたちをノードとし,遷移確率が0でないstateをつないだ有向グラフであって,例えばfig.1のようである. また,初期分布を,特別に設定したnull stateからの遷移とみてグラフに書き込むことも出来る.
graphical modelでは対照的に,確率変数たちの独立/従属関係に着目する. ある時刻におけるstate は確率変数であって,と独立でないことがMarkov chainの定義から言える. ある頂点(state)がほかのある頂点(state)に従属しているときに有向辺によってその従属関係を示して,graphical modelを構成する.つまり,
に従属する
という規則をグラフ化する. fig.2 がその例である.
enter image description here

State prediction


から,任意の

が成立する. 番目の要素がであるような横ベクトルであって,

と書くことにすると,

が成立する.

Estimation

sample pathの観測からMakov chainのtransition matrixを推測することが出来る.
の現れ(sample path)のが与えられたとき,そのlog-likelihoodは,
においてみられたからへの推移の回数とすると,

であって,を考えれば,transition matrix の最尤推定は

である. しかし,初期分布を推測するには多くのsample path が必要不可欠である.

Hidden Markov Models

Hidden Markov Models (HMMs)は,観測している値が,直接観測されないMarkov chainが更に確率的に生成しているものであると仮定したモデルである. HMMモデルは広く利用され,例えば,あとで発話をphoneme(音素)のMarkov chainでHMM化し,また,アミノ基の列であるタンパク質をモデル化するのに,タンパク質分子をその構造的特徴のMarkov chainによってHMM化する.
HMMはMarkov chainとmixture modelによって理解できる. fig.3の単純な例を議論する. 時刻はの4つだけで,fig.3.aは何度かの観測によって得られた値の複数のプロットである. 一旦時刻の情報を捨て去って,の値だけを基準にクラスタリングすると,two component mixture

でうまくモデル化出来る. 例えばなどとできる. このmixture modelから(まだ時刻を無視しつつ)各時刻でsampleを生成すると,fig.3.bの楕円の中に収まるようになる. このとき,各時刻における観測値のサンプルは,選ばれたコンポーネントからのみ生成される(fig.4).
各時刻で正しい方の楕円でのみsampleを生成させるためにMarkov chainを使う. Markov chainによって正しい方のcomponentを選ぶようにするのである. すなわち,でのcomponentを,で選んだcomponentによって選ぶ(fig.5).
enter image description here

Probability model

HMMをgraphical modelで書くことによって,全ての確率変数に対する同時確率を簡単に書き下せる. グラフはどの変数がどの変数に依存しているかを明確にし,どの条件付き確率が同時確率のfactorであるかがわかる. fig.5では,

である.

Three problems to solve

  1. 観測値の確率を評価する
  2. 観測値が与えられたとき,最もありそうな隠れたMarkov path を推測する.
  3. 時系列に沿った観測値の集合の集合 から,モデルのパラメータを推測する.

Problem 1.

として,
と計算していくアルゴリズム(forward algorithm)と,と計算していくアルゴリズム(backward algorithm)があり,どちらか一方だけでも計算できるのだが,計算ステップ()が多くなるほど計算量が幾何級数的に増大するので,前後から挟み撃ちして効率的に計算する.
以下はforward algorithmの導出だが,backwardの場合も殆ど同様である.


によって

などと計算できる. 同様に

これを繰り返して,

が得られる. とすると,

さらにとすると,

である.組み合わせて

が任意のに成立する.
これは,

と理解でき,あるいはMarkov propertyによって

からも理解できる.

Problem 2. most likely hidden state sequence (Viterbi)

目的は

なるを求めることだった.

とすると,

が計算できる. であって,これによって

が得られて,これを起点として

によって,を計算していく.
このように,forwad algorithmによっての最大値をごとに計算し,さらにbackward algorithmによって,具体的にを最大化するを求めていくアルゴリズムをViterbi Algorithmという.

Example

enter image description here
fig.1で表されるHMMを例に上のアルゴリズムを考察する.state が選ばれると,,によって観測される値が確率的に決まるとし,,で共通とする.観測点はが与えられていて,を推測する.
まず,が,の変化によってどう振る舞うかを見る. が大きいとき,はほとんど同じ分布になり,観測値が役に立たなくなる.
と近似できるから,となる.
が非常に小さい時,今度はほとんど観測値と制約条件だけが推測に影響するようになる.というのは,

において,(2)の部分が極めて大きな,あるいは極めて小さな値を取るようになり,(1)の部分をほとんど無視できるからである.
が極端な値でない場合には,Markov chainのtransition matrixからstate 2へできるだけ早く移ろうとする性質と,観測値に合ったhidden pathを辿ろうとする性質のバランスを取ろうとする. 例えばなら,most likely state sequenceは1122222である.

Problem 3: estimation

Hidden statesを観測できず,そこから確率的に生成される値のみを観測できるというのは,モデルの全ての変数を知ることなくモデルを推測しようとしているという点でmixture modelと似ている. この問題はmixture modelと同様にEM algorithmを反復的に用いることで解ける. 普通は複数回行われる,すなわちのように観測値が得られるのだが,簡単のためにすなわち観測値は1通りしか無いとする.
EM-algorithmを導く簡単な方法は,まずは全ての変数が観測されているとしてモデルを構成することである.

とすると,complete log-likelihoodは

(1): 初期状態の確率
(2): 各state における,を生成する確率をでの総和
(3): の遷移が起きる回数
(4): 全てのstateの組で,遷移がどれほど起こるかの総和

を緩和させた”soft”なカウント

と定める.

だから,posteriorは

という正規化で計算できて,同様に

したがって

Multiple (partial) alignment

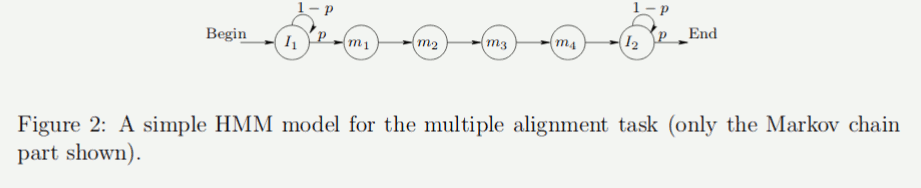
複数の列が与えられるとき,その類似点をさがすのがalignment問題である. そのパターンは,全ての列に存在するということの他にはほとんど情報が得られていないとする. 簡単のため,そのパターンは長さ4であることは既知とする. この状況で考えられる最も簡単なHMMはfig.2である.というstatesは”match states”といって,求めるべきパターンを生成したであろうstatesである. は”insert states”であって,探しているパターン以外の列を生成する. それぞれのstateはというoutput distributionをもつ.これらの分布との値を与えられた列たちから推測する.
enter image description here
このモデルは有限長の列を生成する. に入って最初の要素を生成し,平均ステップにとどまった後,に遷移してパターンを生成し,に遷移してまた平均ステップとどまってから列を終わらせる.
複数の列が与えられたとき,このHMMのパラメータを,EM algorithmによって最尤推定する. ここではまだどこが生成されたパターンなのかは考えず,単にパラメータを最適化する. パラメータが見つかったら,Viterbi algorithmによってそれぞれの観測点がどのhidden stateによって生成されたかを推測する.例えば観測列

という対応の推測が得られたとき,hiddenの列とobesrvationの列には一対一の関係が有り,この例では,パターンはにおいて,すなわちmatch statesが始まったところで始まる.
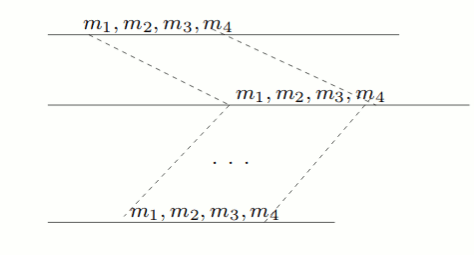
それぞれの観測列でのパターンの部分列はfig.3のようにアラインされる.
figure 3
figure 3

2017年9月13日水曜日

MIT OCW, Machine Learning 14日目

Rohit Singh, Tommi Jaakkola, and Ali Mohammad. 6.867 Machine Learning. Fall 2006. Massachusetts Institute of Technology: MIT OpenCourseWare, https://ocw.mit.edu. License: Creative Commons BY-NC-SA.
Lecture 18.

Specral clustering

データ点の近さの尺度を導入してそれぞれの点同士を頂点とし,辺をその近さの尺度によって重み付けしたグラフを構成できる. spectral clusteringはその重みづけグラフの分割を,固有値問題と考えるアルゴリズムのクラスである. 大きな正の重みで繋がれているノードたちは同じクラスターに入れられることが多い. グラフ表現を行うことで,そのアルゴリズムがノード間の近さだけを基準にして分類を行っていることを際立たせることができる.

Graph construction

ベクトル空間上で表現できる場合にも,グラフ構造での表現には有利な点が有る.例えばfig.1.aの点は2つの半円上の点に分類できるが,これを少数のGaussianの混合で表現することはできない一方,それぞれの点の最近傍の2点をつなげることで,fig.1.bの,非常によく特徴を捉えたグラフが構成できる. このような重み付けグラフを構成するより一般的な方法を議論する. これには多くの方法が有るが,もっとも典型的なのが,上で見たように,k-nearest neighborを使う方法である. すなわち,すべての点について,個の最近傍の点をつなげる無向グラフを作成し,さらに

によって重みを計算する. である. 対角成分は全て0とする.
が選べるパラメータである. は求めたいクラスターたちの次元によって適した値が決まってくる.例えば,クラスターが次元の表面をもつとするなら,が望ましい. 小さなは疎なグラフを作りやすくし,よく似た点たちのみのクラスターが作られるようになる. これは,遠く離れた点ではユークリッド距離を使うのがナンセンスになるような場合に有利である .例えば球面にのみ全てのデータ点が存在して,点たちの距離が球面に沿った距離で図られるべきときには,点が遠くなれば遠くなるほど,ユークリッド距離と球面上の距離が乖離してくることが想像できるだろう.
も同様の役割を果たす.

Graph partitioning and criteria

個の点を2つに分類する問題を定式化する. より多くの種類に分類するときには再帰的に二値分類を適用する. 対象は,重み付け行列で表現されていて,は非負の対称行列で対角成分は0である. を近さの尺度として,ノードたちをの二つに分類する. という変数を定義する.
を決めれば分類は一意に定まり,その分類(cut)に対する重み

を導入する. が異なって分類されると分の重みがにつく. 全てが同じクラスタに分類されるときだから,どちらのクラスタにも同じくらいの数のノードが入るようにするため,minimum cut criterionを導入する. よく使われるcriterionにnormalized cut(Shi and Malik 2000)がある.

である.ただしとする.
この問題を厳密かつ効率的に解く方法は存在しないため,eigenvalue problemによって近似的に解く.

Spectral clustering, the eigenvalue problem

でそれぞれはのどちらかを取ったが,に条件を緩和する.やはりとする.このように二値分類問題を緩和し,eigenvalue問題に帰着させる.まずはcutの重みを改めて表現する.

という対角行列を使って表現した.
graph Laplacianという名でしられ,半正定値行列である. の最小固有値は必ずであり,対応する固有ベクトルはである. normalized cut criterionを考慮すると,最適化問題は

となる. Lagrange multiplierを使うと,

の2番目に小さい固有値を求めることと同じになる(らしい). の符号が有るノードが入るクラスターになる.fig.2はあるspectral cluseringの近似解である.

Spectral clustering, random walk

normalized cut problemを緩和して近似的に解いた.全く異なったアプローチでこの近似方法を正当化する. 重み付きグラフの上でのrandom walkを考えるのである.

によって定義される行列である. で,が成立する.よってを重み付きグラフの上でのrandom walkのtransition matrixと考えることが出来る. すなわち,を時刻(ここでは回目の遷移とする)でのrandom walkのstateを表すとすると,

であって,homogeneous Markov chainと考えることが出来る. Markov chainのstateはこの場合グラフのnodeである. Markov chainのErgodic propertyを定義する.

Definition

Markov chain ergocid

erogodicであるとき,はirreducible かつrecurrentかつstationary distributionをもつ.
stationary distribution である. これまで議論してきた重み付きグラフを上の方法でMarkov chainにするとergodicであり,したがってergodic theoremが成立する.

(以下,講義はもう少し続くが固有値とMarkov chainがどうつながるかわからないので飛ばす.そのうちいい教科書を見つけて読む)