2018年6月20日水曜日

論文読み 2017, Temporal Ensembling for Semi-Supervised Learning manifold

元ネタ: Samuli Laine and Timo Aila, Temporal Ensembling for Semi-Supervised Learning, 2017, ICLR 2017
図表は特に断りがない限りこの論文から引用

複数のモデルのensembleは教師の有無にかかわらずよく使われる手法で,dropoutによる性能向上も内部で複数のモデルのensembleが起きているためだという人もいる.この論文ではdropout(とdata augmentation)によるensembleによって高精度な教師モデルを構成し,生徒モデルが教師モデルの出力を真似ることで半教師あり学習を行う.
Data Distillatinを思い出すが,Data Distillationは教師モデルがハードなラベル(すなわちクラスラベルそのもの)を推測してNLLやCrossEntropyをLossとして生徒モデルを最適化したのに対し,こちらでは同じ入力からの教師モデルと生徒モデルの出力の差異をLossとする. またラベル付きのデータ点に対してのみ,CrossEntropyをLossに足して最適化する.

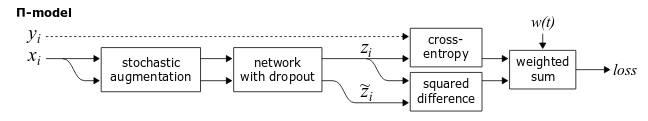
dropoutの場所を変えてensembleを行うΠ\Pi-modelと,過去のepochにおける出力とensembleを行うTemporal ensemblingが提案されている.

Π\Pi-model

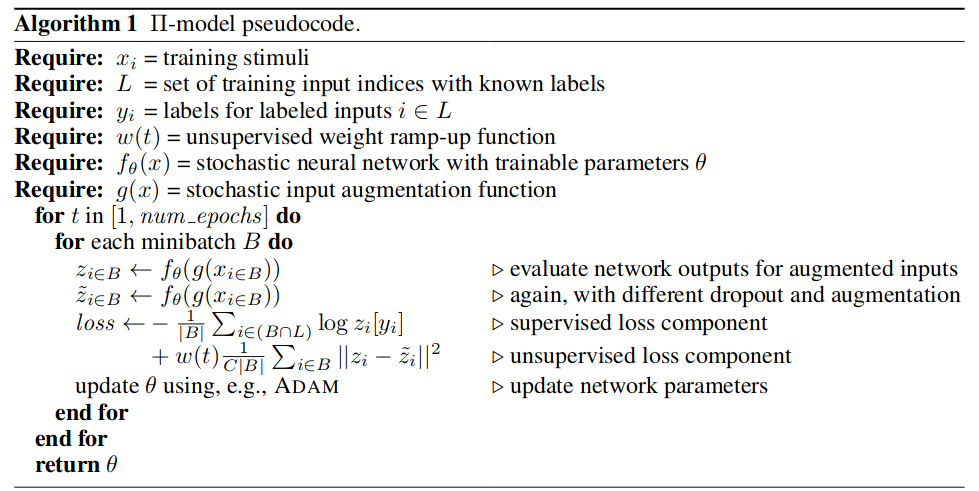
同じexample xxについて,確率的なaugmentationやdropoutによってニューラルネットワークfθf_\thetaは非決定的な関数だから,z=fθ(x),z~=fθ(x)z=f_\theta(x), \tilde{z} = f_\theta(x)は異なっているはずで,その差異zz~\|z - \tilde{z}\|を小さくする.さらにxxがラベル付きであるとき,z,z~z, \tilde{z}とそのラベルの乖離を小さくする.この場合,教師モデルと生徒モデルは同じものである.


fig.1 Π\Pi-modelのダイアグラム

fig.2 Π\Pi-modelのアルゴリズム

Temporal ensembling

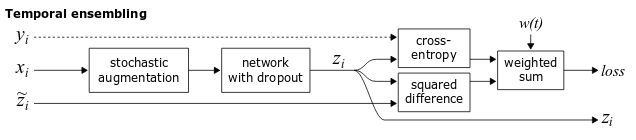
Π\Pi-modelではネットワークのパラメータθ\thetaを変えずにz,z~z, \tilde{z}を計算したが,Temporal ensemblingでは過去のepochで計算した値のexponential moving averageを教師モデルの出力z~\tilde{z}とする.


fig.3 Temporal Ensemblingのダイアグラム


fig.4 Temporal Ensemblingのアルゴリズム

論文読み 2018, Self-ensembling for visual domain adaptation

元ネタ: French and Mackewicz, Self-ensembling for visual domain adaptation, 2018
図表は特に断りがない限りこの論文から引用

Mean Teacherモデルをdomain adaptationに転用. VisDA-17 Classification 優勝

Domain adaptationとは

“新規タスクの効果的な仮説を効率的に見つけ出すために,一つ以上の別のタスクで学習された知識を得て,それを適用する問題”(朱鷺の杜)

例えば人・自動車・犬・猫といった物体ののデータセットから分類モデルを学習し,それらの写真を分類するような問題のことである.学習を行うドメインをsource domain,モデルを適用したいドメインをtarget domainという.この例では絵がsource domainで,写真がtarget domainとなる.
VISDA-2017では3次元モデルから生成した画像をsource domainに,写真をtarget domainとして,domain adaptationモデルを競った.なお,source domainではすべてのデータ点にラベルが与えられ,target domainではunsupervisedな学習が許された.

Self-ensembling for visual domain adaptation


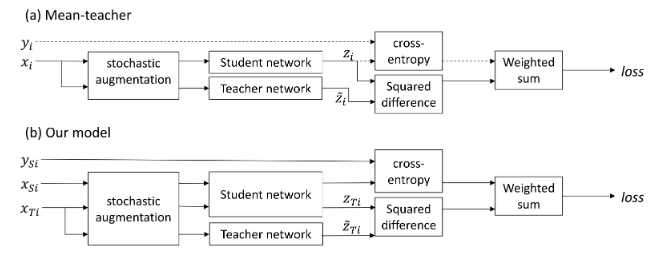
fig.1 (a) mean-teacher (b) self-ensembling for visual domain adaptation
(a)における破線はラベルが与えられた場合にのみ実行されることを示している.

source domainとtarget domainをそれぞれXS,XTX_{S}, X_{T}とする.XSX_{S}には対応するラベルが与えられており,それをYSY_Sとする. Mean-teacherでは,CrossEntropyによるLossはラベルが与えられた場合にのみ最適化していたが,self-ensembling for visual domain adaptationでは教師モデルがtarget domainのデータ点のクラスを推測し,それがconfidence threshold以上であれば,そのラベルを教師データとして生徒モデルの出力とCrossEntropyをlossとして最適化する.

2018年5月24日木曜日

glibcのインストールをしくじったがどうにか復旧した話

問題

CentOS 6.7にPyTorchをインストールしてインポートしようとしたところ,glibc 2.14以上が必要だと怒られた。そこでUnitasBrooks氏の助言に従ってglibcをアップグレードしたつもりが、
export LD_LIBRARY_PATH=/opt/glibc-2.14/lib
を見逃していたため、またPyTorchに怒られてしまった。
私は/opt/glibc-2.14/lib/libc.so.6を直接/lib64にコピーしたのだが、このlibc.so.6というのはシンボリックリンクであって、このような直接的なコピーはシステムを破綻させるものだった。
sudoやlsのような基本的なコマンドを呼ぼうとしてもerror while loading shared libraries: /lib64/libc.so.6: file too short というエラーが出て、ほとんど手も足も出ない状態になった。

解決

Linuxやってみる!, (6) ldconfigでライブラリパスを更新によると、linuxは
(1) 環境変数で指定されたパス
(2) /etc/ld.so.conf に記述されたパス
(3) 通常ライブラリが置かれるパス
の優先順位でライブラリを読み込んでいく。今回は(3)を壊してしまったので、(1)か(2)でうまく正しいglibcライブラリを読み込むようにさせる。それに使えるコマンドにexport (環境変数にパスを追加する) とldconfig (共有ライブラリの依存関係を更新する=(1)~(3)の順でライブラリを読み込み直す?) があり、

$export LD_LIBRARY_PATH=/opt/glibc-2.14/lib
$ldconfig

を実行することでとりあえず復旧できた。
上の操作をする前にはsucpを実行しようとすると

su: error while loading shared libraries: /lib64/libc.so.6: file too short
cp: error while loading shared libraries: /lib64/libc.so.6: file too short

と同じエラーを返していたが、上の操作の後、lscpは動くようになったが、susudoは同じエラーを返してくる。これらはスーパーユーザー権限を得るコマンドなので、ldconfigという、通常のユーザーが実行できるコマンドで何か悪さができないよう、何か特別な仕組みがあるというのは想像できることだが、sudoできないと困る。

Eliah Kagan氏のコメントが力になる気がする・・・

2018年5月8日火曜日

論文読み 2018, 1cycle policy

The 1 cycle policy

ネタ元: A DISCIPLINED APPROACH TO NEURAL NETWORK HYPER-PARAMETERS: PART 1 - LEARNING RATE, BATCH SIZE, MOMENTUM, AND WEIGHT DECAY, Leslie N. Smith, 2018

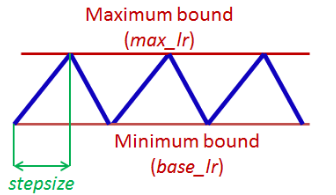
著者の過去の論文では,learning rateを図1のように,イテレーションの間で何度も大きくしたり小さくしたり変化させる(boundaryの決め方は後で).この,小さなlearning rateがmax_lrに至り,またもう一度base_lrになるまでを著者はcycleと呼んでいる.
図1図1

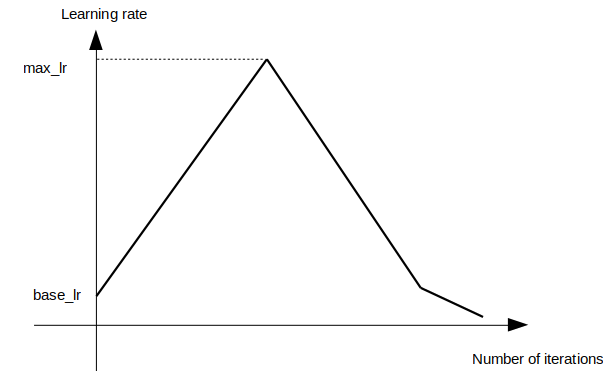
一方,この論文では図2のように,最初は小さいlearning rateから初めて,全学習過程においてただ1度だけcycleを回し,最後にbase_lrよりも小さいlearning rateに線形に変化させている.
図2

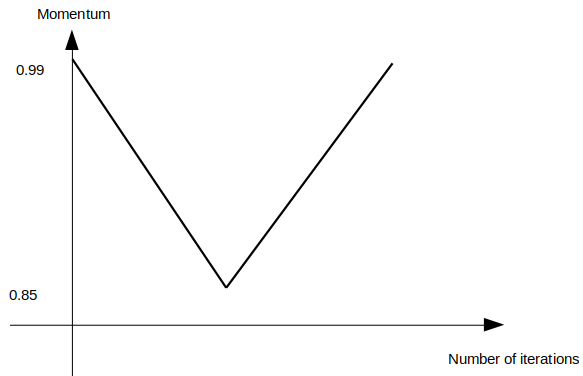
また,learning rateとmomentumがともに大きいと学習が不安定になるので,momentumは図3のようにlearning rateとは反対の方向に減らしたり増やしたりすることを提案している.
図3

これによって高速かつ高性能なモデルが学習できるという.
また著者は大きなlearning rateはregularizationに有益と主張していて,そのため他のregularizationの手法の力を弱めるべきだと主張している.例えばweight decayやdropoutの係数を小さくするなどである.

max_lr, base_lrの決め方
学習を小さなlearning rateから初めて徐々に大きくしていく.最初はvalidation errorは小さくなっていくが,ある値からはvalidation errorが発散を始める.このときの値をmax_lrとし,base_lrはmax_lrの0.1~0.05倍とする.

(イテレーション回数は試行錯誤して決めるしかないようだ)

2018年4月24日火曜日

RefineDet メモ 2

PytorchSSD の実装で,loss functionは,ARM, ODMの出力に対してそれぞれarm_criterion , odm_criterion で、ともにPytorchSSD/layers/modules/refine_multibox_loss.py にあるRefineMultiboxLoss のインスタンスである.

arm_criterion は,PytorchSSD/utils/box_utils.py/match によって,ground truthと最も一致する(Jaccard Indexの大きい) prior boxを計算し,そのprior boxに対応する arm_locarm_conf の組に対してconfidence lossとlocalization loss を計算する.さらに,ground truthに対応していないがarm_conf が高いものたちを選んでconfidence loss を計算し,足す(Hard negative mining).
([Learning Note] Single Shot MultiBox Detector with Pytorch が参考になる)

arm_criterion ではPytorchSSD/utils/box_utils.py/match を,ground truthとprior boxの対応づけにつかうのだが, loc_criterionでは PytorchSSD/utils/box_utils.py/refine_matchによって,ground truthとarm_loc を対応づけて,そのarm_loc に対応したodm_locodm_conf の組に対してarm_criterion と同じ操作を行う(confidence loss はクラスごと).

もとの論文では,ARMはbounding boxの粗いlocalizationを行う ((2) coarsely adjust the locations and sizes of anchors) としていたが,この実装では特別ARMでのbounding box regressionを粗くする工夫は見当たらなかった(オリジナルの実装にはあるのかも).

2018年4月23日月曜日

RefineDet メモ1

RefineDetSSDの進化系.CNNは後ろの方のレイヤーほど(poolingによって)空間的な情報を失い,抽象的な情報を持つようになってくるので,SSDの検出器は前の方にある検出器の性能が低く,したがって小さい物体の検出が苦手だった.(参考:リアルタイム物体検出向けニューラルネット、SSD(Single Shot Multi Detector)及びその派生モデルの解説)
そこで,後ろの方のレイヤーの情報をTransposed Convolutionによって大きくして前のほうのレイヤーと足し合わせ(Elementwise sum)(fig.1),前の方のレイヤーがより多くの抽象的な情報を利用できるようにした.さらにAnchor Refinement Module(ARM)という,bounding boxのあらいrefinementと,objectである/ない の2値のクラス分類を行うモジュールと,Object Detection Module(ODM)という,bounding boxの精密なrefinementとobjectのクラス分類をおこなうモジュールを併用している(fig.2).

figure 1
(figure 1)

(figure 2)

PyTorch実装の一つであるPytorchSSDのコードを読んで混乱したところがあったのでいくつかメモする.

PytorchSSD/models/RefineSSD_vgg.py

ARM部分(fig.3). VGGと追加のレイヤーからの出力(feature map)のうち,いくつかは arm_sources というリストに入れられる.self.arm_loc というレイヤーがバウンディングボックスの座標(x, y, width, height)をself.arm_conf というレイヤーがobjectであるか否かという二値の推定を行い,その値は arm_loc, arm_conf というリストに格納される. arm_sources はARMでは変更されず,そのままTCBに渡される.

(figure 3)

TCB部分(fig.4). TCBというブロックをまとめて実装しているのではなく,ARMからの情報 arm_sourcesをconvolutionするself.trans_layers ,Transposed Convolutionによって小さなfeature mapを引き伸ばすself.up_layers , それらの結果の和をODMに引き渡す前にconvolutionを行うself.latent_layers というレイヤー群をそれぞれ実装していて,最終的にODMに渡す値は obm_sources である.
(この実装ではobmというワードが散見されるが,おそらくODMのタイポである. 混在しててこわい.)

(figure 4)

ODM部分(fig.5).
obm_sourcesself.obm_loc, self.obm_conf に渡され,それぞれbounding boxの精密な座標と,objectのクラス分類を行い,結果はobm_loc, obm_conf に格納される.

(figure 5)

2018年3月20日火曜日

オートエンコーダーによるクラスタリング

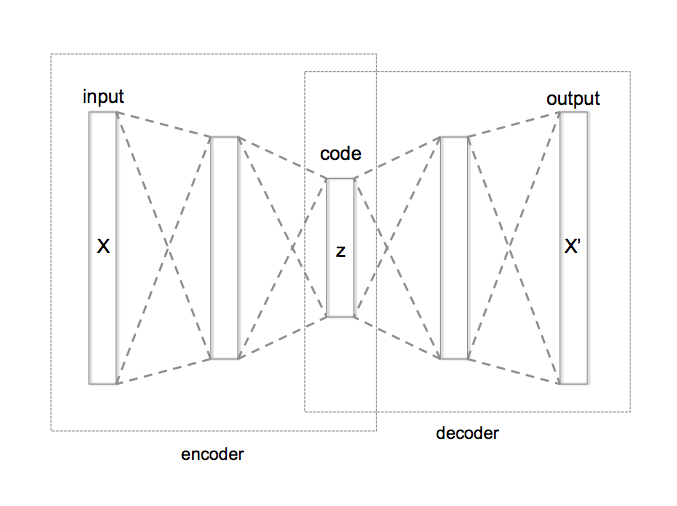
AutoEncoder(AE)は一般に砂時計の形をしたNNで,入力の次元よりも小さい次元に一旦情報を落とし込み(code),また元の次元の情報を再構成する.再構成された情報と元の入力の誤差によって学習を行うため,self-supervisedな学習と言われる.AEによる次元削減を利用してクラスタリングを行うことができる.もとのデータが高次元過ぎるとk-meansのような伝統的なクラスタリングアルゴリズムがうまく動かないので,低次元な空間に写してクラスタリングを行うのである.直感的には移した先の空間で従来のクラスタリングを行うのが簡単だが,アルゴリズムの途中でNNのパラメータを更新するアルゴリズムもある.今回はAEによるクラスタリングについての3本の論文を読む.
以下,データセットを\(\{x_1, ..., x_n\} = X \subset \mathbf{R}^{D_{X}}\)とし,AEによってそれぞれの元は\(\{z_1, ..., z_n\}=Z \subset \mathbf{R}^{D_{Z}}\)に写されるとし,その写像を\(\phi_W\)と書き,クラスターの数を\(K\)とする.

I. Unsupervised Deep Embedding for Clustering Analysis, 2016

1. parameter initialization

深いAEを学習させるため,すべての層を同時に学習させるのではなく,それぞれの層を取り出して隠れ層1のAEとして学習させ,あとで結合させる学習法をStacked AutoEncoder(SAE)という. この論文ではSAEによってfully connectedなAEを学習させて,\(\phi_W\)の初期値を決定している.
\(\{z_i\}_1^n = \{\phi_W(x_i)\}_1^n\)を得て,さらにk-meansで\(\{z_i\}\)のセントロイドの集合\(\{\mu_j\}_1^K\)を計算する.

2. optimization

(1) soft assignment

\(z_i\)がセントロイド\(\mu_j\)に属している確率\(q_{ij}\)をt分布によって以下のように計算する.(\(\alpha=1\)に統一)
\[q_{ij} = \frac{(1+\|z_i - \mu_j\|^2/\alpha)^{-\frac{\alpha + 1}{2}}}{\sum_{j'} (1+\|z_i - \mu_j'\|^2/\alpha)^{-\frac{\alpha + 1}{2}}}\]

(2) KL divergence minimization

auxiliary target distribution \(P\)を導入する. \(P\)は真の分布に近いと仮定されており,本アルゴリズムがやることはsoft assignmentと\(P\)を合致させることであって,そのために,soft assignment \(Q\)と\(P\)のKL divergenceを目的関数として最小化する:
\[L = D_{KL}(P||Q) = \sum_i \sum_j p_{ij} \log \frac{p_{ij}}{q_{ij}}\]
\(P\)の選び方は難しい問題で,論文内では
\[p_{ij} = \frac{q^2_{ij} / f_j}{\sum_{j'} q^2_{ij'} / f_j'}, \ f_j = \sum_i q_{ij}\text{ (soft cluster frequency)}\]
としている…
\[\frac{\partial L}{\partial z_i} = \frac{\alpha + 1}{\alpha} \sum_j \left(1 + \frac{\|z_i - \mu_j\|^2}{\alpha} \right)^{-1}\]
\[\frac{\partial L}{ \partial \mu_j } =-\frac{\alpha + 1}{\alpha} \sum_i \left(1 + \frac{\|z_i - \mu_j\|^2}{\alpha} \right)^{-1} \times (p_{ij}-q_{ij})(z_i-\mu_j)\]
が成立し,これをNNに渡してbackpropagationすることでNNをも同時に更新でき,新しい\(Z\)の点\(\{z_i\}\)とセントロイド\(\{\mu_j\}\)が計算できる. NNを更新しない場合.つまり\(\{\mu_j\}\)だけを更新する場合,NNを更新する場合よりも性能が下回る.
データ点のクラスター間の変動が,総データ数\(n\)の\(tol\) %を下回ったら計算を打ち切る.

II. Deep Clustering with Convolutional Autoencoders, 2017

Iの自然な拡張. AEをCovolutional AutoEncoderに変更し,空間的な情報をより活用できるとしている. Poolingではなくstrided convolutionによってencodeし,strided transposed convolutionによってdecodeしている.
enter image description here
また,I.ではdecoder部分は削除していたが,この論文では残し,objective functionにreconstruction lossを加えて,code部分が空間情報を再構成するための情報を保存するようにしているこれによって,単にAEをCAEに変えただけの場合よりも性能が向上している.

III Deep Clustering via Joint Convolutional Autoencoder Embedding and Relative Entropy Minimization

(I, IIと揃えるため,auxiliary distributionをP, それに近づけていくモデル分布をQとする)
このアルゴリズムはモデルの分布\(Q\)に近く,事前分布を満足する\(P\)を推定(expectation step)してから,\(P\)に近づくようにモデル分布\(Q\)を更新する(maximization step).
\(\mathbf{R}^{d_Z}\)を\(\mathbf{R}^K\)に移す写像\(f_\theta\)を
\[f_\theta(z) = \frac{\exp(\theta^T_k z_i)}{\sum_{k'} \exp(\theta^T_{k'} z_i)}\]
と定める.このとき,\(x_i\)がクラスター\(j\)に属する確率を\(f_\theta(z_i)\)とする.つまり
\[q_{ij} = P(y_i = j| z_i, \theta) = \frac{\exp(\theta^T_k z_i)}{\sum_{j'} \exp(\theta_{j_i}^T z_i)}\]
である.ただし\(\theta = [\theta_1, ..., \theta_k] \in \mathbf{R}^{d_z \times K}, f_\theta: Z \rightarrow Y \subset \mathbf{R}^K\) .

\(f_\theta\)と\(\phi_W\)によってこのモデルの分布\(Q_{\theta, W}\)が決まる.auxiliary distribution Pを用意すると,KL divergenceは
\[D_{KL}(Q||P) = E_Q [\log Q(X)/P(X)] = \frac{1}{N} \sum_I^N \sum_j^K p_{ij} \log \frac{p_{ij}}{q_{ij}}\]
また,殆どのデータ点を一つのクラスターに入れてしまうような解を避けるため,regularization項を追加する.そのため,Pのラベルの頻度分布\(f_j = \frac{1}{N} \sum_i p_{ij}\)と,事前知識から得られるラベルの一様分布\(\mathbf{u}\)(ここでは一様分布)を定義して,
\[ \begin{aligned}L &= D_{KL}(P||Q) + D_{KL} (\mathbf{f} || \mathbf{u}) \\&=\frac{1}{N} \sum_{i}^N \sum_j^K \left[q_{ij} \log \frac{q_{ij}}{p_{ij}} + q_{ij} \log \frac{f_j}{u_j}\right] \end{aligned}\]
と目的関数を定める.\(L\)を最小化する\(P\)は
\[p_{ij} = \frac{q_{ij} / (\sum_{i'} q_{i'j})^{1/2}}{\sum_{j'} q_{ij'} / (\sum_{i'} q_{i'j'})^{1/2}}\]
さらに\(Q\)を更新するための目的関数は通常のクロスエントロピーと同じ
\[-\frac{1}{N} \sum_i \sum_j p_{ij} \log q_{ij}\]
で,backpropagationによってNNのパラメーターを更新できる.

DEPICT

enter image description here

decoderとパラメータを共有する2つのAEを用意し,片方(corrupted pathway)にはノイズをかけた画像,もう一方(clean pathway)にはクリーンな入力を与える. パラメータの更新はもっぱらclean pathwayで行う(更新の結果はcorrupted pathwayにも適用される). corrupted pathwayが\(Q\)を計算することでより頑強な分布\(Q\)を得られ,clean pathwayが\(P\)を計算し,パラメータ更新をすることでより精度の高いauxiliary distributionを得られるとしている.
NNの目的関数は\(l=0, ..L-1\)をAEの\(l\)層として
\[\frac{1}{N} \sum_i \sum_j p_{ij} \log \tilde{q_{ij}} + \frac{1}{N} \sum_i \sum_{l=0}^{L-1} \frac{1}{|z^l_i|} \|z^l_i - \hat{z}^l_i\|^2\]
とし,backpropagationによってパラメータを更新する.

IV 性能比較

accuracy/normalized mutual information MNIST-FULL USPS
DEC 0.844/0.816 0.702/0.693
DCEC 0.890/0.885 0.790/0.826
DEPICT 0.965/0.917 0.964/0.927

DCECはその論文から,DECとDEPICTはDEPICT